Pythonによるバックテスト2
前回に続いてBacktesting.pyを利用してバックテストを行っていきたいと思います。今回は機械学習を使ったトレードを検証していきたいと思います。
データはXMTradingから取得したものを利用しています。口座登録するとMT4やMT5を使ったトレードが行えるようになります。私はXMを使ってトレードを行っています。
MetaTraderのインストール
MT5が既にインストールされている方は飛ばしてください。
- まずはMT5をインストールします。
- PythonからMetaTrader5を使うためのパッケージをインストールします
pip install MetaTrader5
データの取得
為替、商品、仮想通貨などのデータを取得する前に、まずは口座にログインする必要があります。XMの場合は以下のようにします。
import MetaTrader5 as mt5

LOGIN_ID="" # ご自身のID
PASSWORD="" # ご自身のパスワード

if not mt5.initialize(server="XMTrading-MT5 3", login=LOGIN_ID, password=PASSWORD):
    print("initialize() failed")
    mt5.shutdown()
XMのログインIDとパスワードを入力するとXMに接続できるようになります。実際にEAや機械学習を使ったトレードを行う場合は、スプレッドや通信速度の観点から使用するブローカーの口座で実験をすることをお勧めします。
ティックデータの取得
ティックデータを取得するにはcopy_ticks_from()関数を利用します。使いやすいように以下のような関数を作成します。
import datetime
import pytz
import pandas as pd


def fetch_tickdata(symbol, utc_from, count):
    ticks = mt5.copy_ticks_from(symbol, utc_from, count, mt5.COPY_TICKS_ALL)
    print("Ticks received:", len(ticks))
    tick_data = pd.DataFrame(ticks)
    return tick_data
2023年4月1日からデータを10000点取得する場合は以下のようになります。
utc_from = datetime.datetime(2023, 4, 1, tzinfo=pytz.timezone("Etc/UTC"))
tick_data = fetch_tickdata("USDJPY", utc_from, 10000)
tick_data.head()

time	bid	ask	last	volume	time_msc	flags	volume_real
0	1680480003	133.365	133.458	0.0	0	1680480003126	230	0.0
1	1680480004	133.363	133.457	0.0	0	1680480004793	230	0.0
2	1680480005	133.363	133.458	0.0	0	1680480005063	100	0.0
3	1680480006	133.360	133.460	0.0	0	1680480006411	230	0.0
4	1680480010	133.360	133.456	0.0	0	1680480010268	100	0.0
ティックデータの場合はデータ数が膨大になるため、取得するデータ数には注意が必要です。時間はUTC(協定世界時)にしています。また、データフレーム内に得られている時間はUnix時間です。
得られたティックデータからOHLCVデータを作成するには以下のようにします。
def tick_to_ohlcv(data,  rule = "10T", is_ask=True):
    tick_data = data.copy()
    tick_data["time"] = pd.to_datetime(tick_data.time, unit="s")
    tick_data.set_index("time", inplace=True)
    df = tick_data.copy()
    # ティックデータからOHLCVデータを作成する
    if is_ask:
        ohlcv = df.ask.resample(rule).ohlc()
    else:
        ohlcv = df.bid.resample(rule).ohlc()
    # ティック数から出来高(VOLUME)を計算する
    ohlcv["volume"] = df.ask.resample(rule).count()
    ohlcv.dropna(inplace=True)
    ohlcv.columns = [col.capitalize() for col in ohlcv.columns]
    return ohlcv
10分足のデータを取得するには以下のようにします。
ohlcv = tick_to_ohlcv(tick_data, rule="10T")
ohlcv

Open	High	Low	Close	Volume
time
2023-04-03 00:00:00	133.458	133.460	133.314	133.325	107
2023-04-03 00:10:00	133.318	133.326	133.309	133.315	42
2023-04-03 00:20:00	133.315	133.316	133.315	133.316	9
2023-04-03 00:30:00	133.316	133.435	133.315	133.353	148
2023-04-03 00:40:00	133.351	133.395	133.330	133.374	73
なお、1時間足ならrule=“1H”, 日足なら"1D"のようになります。
OHLCVデータの取得
ティックデータを変形して、OHLCVデータを取得するのではなく、直接得るためには、mt5.copy_rates_from()を利用します。
こちらも使いやすいように関数にしておきます。
def fetch_data(symbol_list, timesteps=mt5.TIMEFRAME_M1, num_data=1000):
    df_dict = {}
    now = datetime.datetime.now()
    for symbol in symbol_list:
        tmp = mt5.copy_rates_from(symbol, timesteps, now, num_data)
        tmp = pd.DataFrame(tmp)
        tmp["tic"] = symbol
        tmp["time"] = tmp.time.apply(
            lambda ts: datetime.datetime.utcfromtimestamp(ts).strftime(
                "%Y-%m-%d %H:%M:%S"
            )
        )
        df_dict.update({symbol: tmp})

    df = (
        (
            pd.concat(df_dict.values())
            .reset_index()
            .loc[:, ["time", "open", "high", "low", "close", "tick_volume", "tic"]]
            .sort_values(by="time")
        )
        .reset_index()
        .drop(columns=["index"])
    )
    return df
こちらの関数では複数のシンボルからデータを取得できるようにしています。というのも、トレードしている銘柄についてポートフォリオを最適にする際に便利だからです。
ここでは、USDJPYの1時間足を最新時刻から1000点分取得します。
data = fetch_data(symbol_list=["USDJPY"], timesteps=mt5.TIMEFRAME_H1, num_data=1000)
data

time	open	high	low	close	tick_volume	tic
0	2020-04-15 11:00:00	107.354	107.507	107.325	107.445	3958	USDJPY
1	2020-04-15 12:00:00	107.445	107.457	107.326	107.364	2616	USDJPY
2	2020-04-15 13:00:00	107.364	107.376	107.259	107.352	2926	USDJPY
3	2020-04-15 14:00:00	107.352	107.418	107.314	107.368	2480	USDJPY
4	2020-04-15 15:00:00	107.369	107.604	107.360	107.543	4661	USDJPY
複数銘柄の場合は以下のようになります。
data = fetch_data(symbol_list=["USDJPY", "EURUSD"], timesteps=mt5.TIMEFRAME_H1, num_data=1000)
data

time	open	high	low	close	tick_volume	tic
0	2020-04-15 11:00:00	107.35400	107.50700	107.32500	107.44500	3958	USDJPY
1	2020-04-15 11:00:00	1.09289	1.09390	1.09196	1.09316	4196	EURUSD
2	2020-04-15 12:00:00	1.09316	1.09382	1.09254	1.09334	3405	EURUSD
3	2020-04-15 12:00:00	107.44500	107.45700	107.32600	107.36400	2616	USDJPY
4	2020-04-15 13:00:00	107.36400	107.37600	107.25900	107.35200	2926	USDJPY
このようなデータセットを使うと、「ドル円」、「ユーロドル」をどれくらいの比率で持っていればリスクを最小にできるかなどを計算できるようになります。どのようにポートフォリオ最適化を行うかについては今後記載できたらと思います。元々は株で行われると思いますが、FXでも同様に行います。
機械学習モデルの作成
機械学習が何かについては、様々なサイトで取り上げられているため、このブログで記載することは最小限にしたいと思います。簡単に説明すると、機械学習モデルは、予測対象であるターゲットyと、それを説明するために特徴的なデータXが与えられた時、
$$ y = f(X) $$
となるような関数fをデータから発見することを目的にしています。
金融においては、Xが各期間での移動平均値などを表し、yはある期間でのリターンです。これまでの移動平均値から将来のリターンを予測することができれば、ある特定の移動平均値のときにロングもしくはショートすれば良いということになります。
これまで、人が取引戦略のルールを定めていましたが、機械学習ではデータから学習することができます。
それでは1時間足のドル円データを利用して機械学習モデルを構築して、実際にバックテストをしてみます。 本記事は、Trading with Machine Learningを参考にして実装し直したものになります。
特徴量Xの計算
ここでは
- ボリンジャーバンド
- 単純移動平均
- モーメンタム
- 日付特徴
を計算して、それらがリターンyを予測するための特徴量Xであるとします。
ボリンジャーバンド
ボリンジャーバンドは、ある価格が平均とのズレを表したテクニカル指標です。ボリンジャーバンドの上限・下限は、特定期間のデータの標準偏差を使って算出されます。このレンジがボラティリティを表していると考えられます。
def BBANDS(data, n_lookback, n_std):
    """Bollinger bands indicator"""
    hlc3 = (data.High + data.Low + data.Close) / 3
    mean, std = hlc3.rolling(n_lookback).mean(), hlc3.rolling(n_lookback).std()
    upper = mean + n_std * std
    lower = mean - n_std * std
    return upper, lower
ここでのボリンジャーバンドの計算では、クローズ値ではなく(High + Low + Close) / 3のティピカルプライスを利用しています。移動平均やモーメンタムの計算は以前解説した記事に詳細を載せています。
全体の計算
OHLCVから特徴量Xを計算するには以下のように関数を作成します。
def preprocess_data(ohlcv):
    data = ohlcv.copy()
    close = data.Close.values
    sma10 = SMA(data.Close, 10)
    sma20 = SMA(data.Close, 20)
    sma50 = SMA(data.Close, 50)
    sma100 = SMA(data.Close, 100)
    mean, upper, lower = BBANDS(data, 20, 2)

    # Design matrix / independent features:
    # Price-derived features
    data["X_SMA10"] = (close - sma10) / close
    data["X_SMA20"] = (close - sma20) / close
    data["X_SMA50"] = (close - sma50) / close
    data["X_SMA100"] = (close - sma100) / close
    data["X_DELTA_SMA10"] = (sma10 - sma20) / close
    data["X_DELTA_SMA20"] = (sma20 - sma50) / close
    data["X_DELTA_SMA50"] = (sma50 - sma100) / close

    # Indicator features
    data["X_MOM"] = data.Close.pct_change(periods=2)
    data["X_BB_mean"] = mean / close
    data["X_BB_upper"] = (upper - close) / close
    data["X_BB_lower"] = (lower - close) / close
    data["X_BB_width"] = (upper - lower) / close

    # Time features
    data["X_day"] = data.index.dayofweek
    data["X_hour"] = data.index.hour
    data = data.dropna().astype(float)
    return data
ターゲットyの計算
リターンの値を直接予測しに行っても良いのですが、市場データを予測するのは非常に困難です。そこで、リターンがプラスなら+1、マイナスならば-1であるというラベル付けを行います。また、リターンが非常に小さい場合は0であるします。このラベルを識別しに行くモデルを作成します。モデルの予測値が+1であればロングをし、-1であればショートをするという戦略を立てることができます。正しくモデルが学習されればより良い戦略になりそうです。
今回は1時間足を使うので、48時間(すなわち2日)後のラベルを予測する対象とします。
def get_y(data, timestep=48):
    """Return dependent variable y"""
    # timestepでのリターンを計算する
    y = data.Close.pct_change(timestep).shift(-timestep)
    # 0.4%よりも小さいリターンは0にする
    y[y.between(-0.004, 0.004)] = 0
    y[y > 0] = 1
    y[y < 0] = -1
    return y
前処理
まず、Backtesting.pyを利用できるようにするため、XMから取得してきたデータを整形します。
data = fetch_data(symbol_list=["USDJPY"], timesteps=mt5.TIMEFRAME_H1, num_data=1000)
data["time"] = pd.to_datetime(data.time)
data.set_index("time", inplace=True)
data.rename(columns={"tick_volume": "Volume"}, inplace=True)
data.columns = [c.capitalize() for c in data.columns]
data = data.drop(labels=["Tic"], axis=1)
processed = preprocess_data(ohlcv)
このようにすることで、ドル円の1時間足のデータに整形して、特徴量Xを作成することができます。データは2023年5月10日から6月30日までのデータで約900点となります。
次に、特徴量XにはOpen, High, Low, Close, Volumeなどがありますが、こちらは予測時に使えないためデータから除外します。filterを使って名前にXが含まれているものだけ抽出します。
def get_X(data):
    """Return model design matrix X"""
    return data.filter(like="X").values
nanが含まれている場合は除外します
import numpy as np

def get_clean_Xy(df, pct=48):
    """Return (X, y) cleaned of NaN values"""
    X = get_X(df)
    y = get_y(df, pct).values
    isnan = np.isnan(y)
    X = X[~isnan]
    y = y[~isnan]
    return X, y
また、モデルを評価するために学習用とテスト用に分割します。これはscikit-learnのtrain_test_splitを行うと簡単にできます。注意点としては、shuffleという引数がデフォルトでTrueであり、もしTrueにしてしまうと、未来と過去が入り混じってしまうため、Falseにする必要があります。今回はテストの比率を10%とします。このようにすることで前半90%が学習、後半10%がテストとなり、実際に運用する際の指針になります。
from sklearn.model_selection import train_test_split

X, y = get_clean_Xy(processed, pct=48)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.1, shuffle=False)
機械学習モデルの作成
実際に機械学習モデルを作ってリターンがプラスになるか、マイナスになるかを予測ができるか検証してみます。様々なモデルがありますが、ここではKaggleなどのデータサイエンスコンペでよく利用されるLightGBMというモデルを利用します。
LightGBMは以下のようにしてインストールできます。
pip install lightgbm
使い方は非常に簡単です。LGBMClassifier()を読み込んで、fit, predictを行うだけで学習から予測が行えます。
from lightgbm import LGBMClassifier
clf = LGBMClassifier()
clf.fit(X_train, y_train)
y_pred = clf.predict(X_test)

_ = pd.DataFrame({'y_true': y_test, 'y_pred': y_pred}).plot(figsize=(15, 2), alpha=.7)
print('Classification accuracy: ', np.mean(y_test == y_pred))
Classification accuracy:  0.5813953488372093
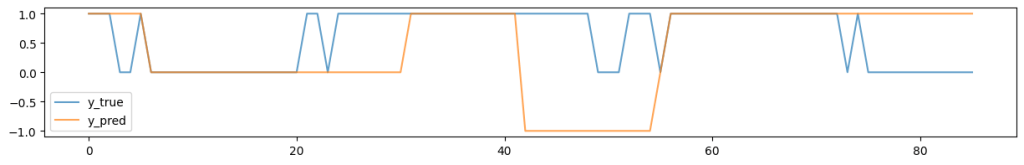
未知のデータに対する予測結果は58%でリターンを予測できるという結果になりました。予測結果の図を見るとあまり予測できているようには思えませんが、こちらのモデルを使って実際にバックテストを行ってみます。なお、実際に運用する際は特徴量を変えたり、モデル特有のハイパーパラメータを調整する必要があります。
バックテストの実行
Backtestの機能を使って機械学習を使った戦略を実装していきます。
機械学習戦略
from backtesting import Backtest, Strategy

N_TRAIN = 400


class MLTrainOnceStrategy(Strategy):
    price_delta = 0.004  # 0.4%

    def init(self):
        self.clf = LGBMClassifier()
        df = self.data.df.iloc[:N_TRAIN]  # 最初の400点を使って学習する
        X, y = get_clean_Xy(df, pct=1)
        self.clf.fit(X, y)

        # yを可視化するためのインジケータ(可視化用)
        self.I(get_y, self.data.df, name="y_true")
        # 予測用のインジケータ(可視化用)
        self.forecasts = self.I(
            lambda: np.repeat(np.nan, len(self.data)), name="forecast"
        )

    def next(self):
        # 学習期間は何もしない
        if len(self.data) < N_TRAIN:
            return

        # Proceed only with out-of-sample data. Prepare some variables
        high, low, close = self.data.High, self.data.Low, self.data.Close
        current_time = self.data.index[-1]

        # 次の動きを予測する
        X = get_X(self.data.df.iloc[-1:])
        forecast = self.clf.predict(X)[0]

        # 予測用のインジケータに値を格納する
        self.forecasts[-1] = forecast

        # 予想が上向きで、まだロング・ポジションを保有していない場合、
        # 利用可能な口座資本の20%でロング注文を出す。ショートの場合はその逆
        # また、目標利益確定価格と損切り価格を、現在の終値から価格デルタで1つ離れたところに設定する
        upper, lower = close[-1] * (1 + np.r_[1, -1] * self.price_delta)

        if forecast == 1 and not self.position.is_long:
            self.buy(size=0.2, tp=upper, sl=lower)
        elif forecast == -1 and not self.position.is_short:
            self.sell(size=0.2, tp=lower, sl=upper)

        # 2日以上未決済の取引には損切りを設定する
        for trade in self.trades:
            if current_time - trade.entry_time > pd.Timedelta("2 days"):
                if trade.is_long:
                    trade.sl = max(trade.sl, low)
                else:
                    trade.sl = min(trade.sl, high)
実行結果
手数料が0.02%で、レバレッジが20(1/0.05)倍での設定です。
bt = Backtest(processed, MLTrainOnceStrategy, cash=1e7, commission=0.0002, margin=0.05)
output = bt.run()
bt.plot()

結果を見ると全然取引をしていないことがわかります。最初に学習した期間だけを使ってトレードすると、新しい環境に対応できないためであると思われます。
WalkForward戦略
相場は刻一刻と変わっていきます。そのために、データが追加されるたびに最学習した方が良いです。
再学習の実装
再学習を実装するために、MLTrainOnceStrategyを継承し、先ほどのロジックを利用できるようにします。
今回は20イテレーションごとに再学習をするようにします。
class MLWalkForwardStrategy(MLTrainOnceStrategy):
    def next(self):
        if len(self.data) < N_TRAIN:
            return

        # 20イテレーションごとに再学習
        # この期間を増やすと計算時間が増えることに注意
        if len(self.data) % 20:
            return super().next()

        # 最後のN_TRAINの値を使って再学習
        df = self.data.df[-N_TRAIN:]
        X, y = get_clean_Xy(df)
        self.clf.fit(X, y)

        # モデルが再学習されたら先ほどのMLTrainOnceStrategyを実行
        super().next()
実行結果
bt = Backtest(processed, MLWalkForwardStrategy, commission=0.0002, margin=0.05)
output = bt.run()
bt.plot()

結果を見るとトータルではプラスになっています。再学習が必要であることがわかりました。2023年5月10日から6月30日のドル円は上昇傾向にありました。その中でもBuy and Hold以上のリターンが得られているのは特筆すべきことかと思います。
一方で、注意すべき点はスリッページをやスプレッドを考慮していない点です。ショート時のマイナススワップポイントなども考えた方が良いかもしれません。とはいえ、このような戦略は有効な部分があると思います。いずれMQL5でも利用できるEAとして公開できたら考えています。
結果一覧は以下の通りです。
| 結果 | |
|---|---|
| Start | 2023-05-10 11:00:00 |
| End | 2023-06-30 23:00:00 |
| Duration | 51 days 12:00:00 |
| Exposure Time [%] | 49.722531 |
| Equity Final [$] | 10895.929226 |
| Equity Peak [$] | 11087.891188 |
| Return [%] | 8.959292 |
| Buy & Hold Return [%] | 6.654147 |
| Return (Ann.) [%] | 76.652982 |
| Volatility (Ann.) [%] | 33.587188 |
| Sharpe Ratio | 2.282209 |
| Sortino Ratio | 6.837782 |
| Calmar Ratio | 12.393635 |
| Max. Drawdown [%] | -6.184867 |
| Avg. Drawdown [%] | -1.200664 |
| Max. Drawdown Duration | 9 days 18:00:00 |
| Avg. Drawdown Duration | 1 days 10:00:00 |
| # Trades | 39 |
| Win Rate [%] | 56.410256 |
| Best Trade [%] | 0.382808 |
| Worst Trade [%] | -0.422741 |
| Avg. Trade [%] | 0.05531 |
| Max. Trade Duration | 2 days 12:00:00 |
| Avg. Trade Duration | 0 days 18:00:00 |
| Profit Factor | 1.447955 |
| Expectancy [%] | 0.055839 |
| SQN | 1.147165 |
注意事項
投資方針、投資タイミング等は、ご自身の責任において判断してください。本サービスの情報に基づいて行った取引のいかなる損失についても、当ブログは一切の責を負いかねますのでご了承ください。また、当ブログは、当該情報の正確性および完全性を保証または約束するものでなく、今後、予告なしに内容を変更または廃止する場合があります。なお、当該情報の欠落・誤謬等につきましてもその責を負いかねますのでご了承ください。