現代ポートフォリオ理論(1)
現代ポートフォリオ理論(Modern portfolio theory, MPT)は、ハリー・マーコウィッツによって研究された金融資産の投資比率(ポートフォリオ)を決定する理論です。
金融資産を有している時、資産は分散させるべきという話を聞いたことがあるかと思います。なぜ、分散させるべきかをこのMPTを使って説明していこうと思います。
ポートフォリオ構築
ポートフォリオを構築する際は以下の原則を守ります。
- アセットの分散化
- ポジションの限度額を定める。例えば、ポジションは純資産額(Net Asset Value, NAV)の5%未満にするなど。
- より強い確信を持てる取引に大きくベットする。
- リスクの観点からベットする金額を決定する。これまでのボラティリティからベットする金額を考慮します。
- アセット間の相関を考慮する。例えば、ロングポジションにおいて、相関が低いような他業種のロングポジションを持つなど
MPTの理論に基づいて、どの程度資産を分散化し、ポジションを持つべきか見ていきます。
平均分散アプローチ
前提条件として、以下のようなものがあります。
- 投資家は合理的かつリスク回避的である:すなわち、投資家は同じリターンを持つポートフォリオがあるとき、リスクが低いものを選びます。
- リターンが正規分布にしたがう:実際の市場データは満たさないこともあります(ファット・テールと呼ばれる現象)。
- 手数料が0
- 無制限の貸借が可能で、金利が一定
平均分散アプローチでは、リターンの平均と分散のみに着目します。
設定
ポートフォリオの期待リターン
ある金融資産iでのリターン(収益率)をRiとします。また、資産をどれくらい持つかの比率を\(w\)で表します。そのとき、ポートフォリオの期待リターンは以下のようになります。 $$ \mathbb{E}[R_p]=\sum_{i=1}^{n}w_i\mathbb{E}[R_i] $$ すなわち、個々のアセットにおける期待リターンに対して、比率wでかけ総和したものが全体の期待リターンです。また、\(w\)は比率なので、総和は1になります。
$$ \sum_{i=1}^{n}w_i=1 $$
ポートフォリオのリスク(リターンの分散)
ポートフォリオの分散は、以下の式で表現できます。 $$ \sigma^2_p = \sum_{i=1}^{n}\sum_{j=1}^{n}w_iw_j\sigma_i\sigma_j\rho_{ij} $$ ここで、\(\sigma\)はある資産での標準偏差で、\(\rho_{ij}\)はアセット\(i, j\)における相関係数です。分散は標準偏差の2乗になるためポートフォリオの分散を表しています。なお、相関係数に標準偏差をかけているため、共分散を表しています。各資産の組み合わせを考えているため、各リスクの総和になっています。リターンのばらつきをリスクと呼びます。
数式の詳細
- 分散と標準偏差
$$ \sigma^2=\frac{1}{n}\sum(X-\bar{X})^2=\text{Var}[X] $$
標準偏差は分散に対してルートをとったもので、ボラティリティとも呼ばれます。
- 分散・共分散
$$ Cov(X, Y)=\frac{\sum(X_i – \bar{X})(Y_i – \bar{Y})}{n} $$
同じアセット同士ならば分散になり、異なるアセット同士ならば共分散です。これらの組み合わせの行列は共分散行列と呼ばれます。共分散行列の逆行列である精度行列も計算ではよく利用されます。
- 相関係数
それぞれのアセットがどれくらい同じ動きかを測定する指標です。標準偏差で割ることで、-1から1の範囲になるようにしています。 $$ \rho_{ij} = \frac{Cov(X_i, X_j)}{\sigma_i\sigma_j} $$
- シャープレシオ
投資のパフォーマンスを測るのにシャープレシオという指標があります。これは期待リターンから無リスク資産のリターンを引いたものに対して、期待リターンのボラティリティ(標準偏差)で割ったものになります。 $$ \text{SR} = \frac{\mathbb{E}[R_p-R_f]}{\sigma_{R_p}} $$
- インフォメーションレシオ
シャープレシオに関連するため記載します。超過リターン\(R_e=R_t-R_f\)を計算する際に、市場全体の動きに対して、単回帰を行うと次のような関係式が得られます。 $$ R_e = \alpha + \beta R_M + \epsilon_t $$ この回帰係数\(\beta\)は市場全体の動きに対してどれだけリターンが追従するかを示しています。これをシステマティックリスクと呼びます。この動きで表せない部分が\(\alpha\)とレジデュアルリスク\(\epsilon_t\)です。すなわち市場中立の超過リターンは $$ R_e – \beta R_M = \alpha+\epsilon_t $$ と表現することができます。期待値を取ると $$ \mathbb{E}[R_e – \beta R_M] = \alpha $$ となります。ここで線形回帰の前提条件として、誤差項(ノイズ)が平均0, 標準偏差\(\sigma\)のガウス分布に従うため、期待値を取ると0になるということです。なお、後ほど記載する資本資産価格モデル(capital asset pricining model, CAPM)では\(\alpha=0\)としています。これはシングルファクターモデルと呼ばれるのですが、FamaとFrenchは1ファクターでは説明できない現象を、さらにバリュー(割安)リターンとサイズに関するリターンの項を追加した3ファクターモデルで説明しようとしました。
インフォーメーションレシオでは、先ほど計算した\(\alpha, \sigma\)を利用して計算されます。 $$ \text{IR} = \frac{\alpha}{\sigma} $$
さて、平均分散アプローチについて、まずは資産が2つの場合を考えてみましょう。
データの取得
実際のデータを使って計算をしてみましょう。まずはYahoo financeからデータを取得します。
- yfinanceのインストール
pip install yfinance
- データの取得
例えばマイクロソフトとグーグル(Alphabet)の日足株価データを2020年4月30日から2023年6月30日まで取得します。
import yfinance as yf

data = yf.download("MSFT GOOG", start="2020-04-30", end="2023-07-01")
data.head()

データの比較
2つの株価を比較しやすくするために、データの初期値を100にした後、可視化します。
import matplotlib.pyplot as plt

df = 100 * df / df.iloc[0, :]
plt.figure(figsize=(12,6))
plt.plot(df.index, df.iloc[:, 0], label=df.columns[0])
plt.plot(df.index, df.iloc[:, 1], label=df.columns[1])
plt.plot(df.index, df.mean(axis=1), "r--",label="Portfolio")
plt.legend()

同じようなテック企業のため、かなり似たような動きをしていますね。赤線のPortfolioはそれぞれ50%ずつ持った場合のポートフォリオです。リターンの相関係数を確認します。
returns = df.pct_change(1).dropna()
corr = returns.corr()
returns.plot.scatter(
    x="GOOG",
    y="MSFT",
    figsize=(6, 6),
    grid=True,
    title=f"Correlation: {corr.values[0,1]:.3f}",
)
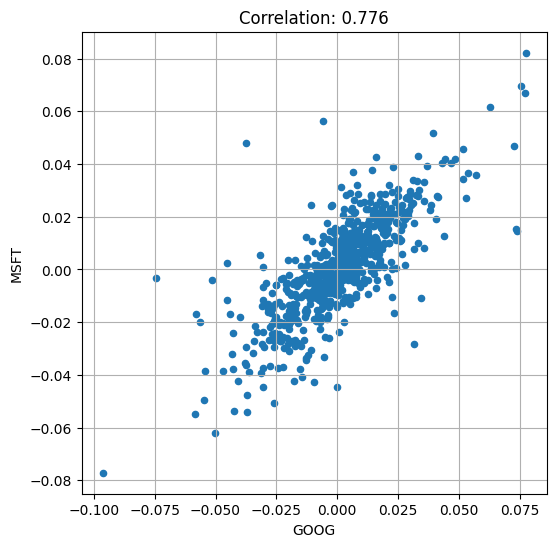
相関係数が0.776と非常に高いことがわかります。この場合、MSFTとGOOGのみの資産でロングをしている場合、どちらか一方が下落すると、両方下落する可能性があるため、リスク分散の観点から良くありません。しかしながら、単一アセットよりも複数アセットの方がリスクが回避できることを示していきたいと思います。
分散効果の検証
今回は複数年にわたるデータであるため、リターンやリスクを年率に変換する必要があります(参考サイト:標準偏差・分散)。日次トレードの場合は250(や252)営業日のルートをかけて換算することが一般的に行われます。
import numpy as np

annualized_return = (1 + returns.mean()) ** 252 - 1
annualized_risk = returns.std() * np.sqrt(252)
annualized_risk, annualized_return
これらの値を使って、ポートフォリオ比率wを変化させていったとき挙動を計算します。
portfolio = {}
corr = returns.corr().values[0, 1]
for w in np.linspace(0, 1, 100):
    w1 = w
    w2 = 1 - w
    ret = w1 * annualized_return[0] + w2 * annualized_return[1]
    risk = (
        (w1 * annualized_risk[0]) ** 2
        + (w2 * annualized_risk[1]) ** 2
        + 2 * corr * w1 * w2 * annualized_risk[0] * annualized_risk[1]
    )
    portfolio.update({(w, 1 - w): [ret * 100, np.sqrt(risk) * 100]})

v = pd.DataFrame(portfolio, index=["return", "risk"]).T
v.index.names = ["GOOG", "MSFT"]
得られた結果を元にリスク・リターンの図示を行います。
# 散布図を描画
import seaborn as sns
sns.set()
plt.figure(figsize=(8, 6), dpi=100)
plt.title("GOOG and MSFT")
plt.plot(v["risk"], v["return"], 'o-')

# 各点にインデックスをテキストとして描画
for idx, row in v.iterrows():
    a, b = round(idx[0], 2), round(idx[1], 2)
    plt.text(row["risk"], row["return"], str((a, b)), fontsize=12)

plt.xlabel("risk")
plt.ylabel("return")
plt.show()

この図は横軸を年率リスク、縦軸を年率リターンとした時に、(グーグル、マイクロソフト)株の保有比率を変えていった時のグラフになります。マイクロソフトを100%持つと(0.0, 1.0)の点になりリターンは最大です。このグラフを見るとリスクが最小になっているのは、(0.33, 0.67)の点になります。すなわち、マイクロソフトの株を全部買うのではなく、グーグル株を33%保有するとリスクが小さくなります。
ポートフォリオの最適化
上図では、点数が少ないため少しカクカクしていますが、データ数を増やすとなめらかな曲線になります。リスクが最小になる点がポートフォリオの最適値です。2変数の場合は簡単に解くことができます。
数式で表現すると以下のようになります。
$$ \min \sigma_p^2 \quad \text{subject to } \sum_{i=1}^{n}\mathbb{E}[R_i]w_i=\mu_p $$
先ほど定義したポートフォリオの期待リターンの条件のもとでポートフォリオの分散を最小にするwを求めるという問題です。n個の金融資産が存在する場合の最小化問題の解析解はロバート・マートンによって与えられていてます(参照:Wiki)。
効率的フロンティア
最適解(最小分散ポートフォリオ)上に存在する曲線は最小分散フロンティアと呼ばれます。その曲線において、リスクを大きくした時に、期待リターンが上昇する曲線部分(上向きの部分)を効率的フロンティアと呼びます。
無リスク資産がある場合
国債のような無リスク資産がある場合は、国債のリターンと効率的フロンティアとの接点を考えます。
この接点が最適ポートフォリオになります。この時の直線を**資本市場線(capital market line, CML)**と呼びます。
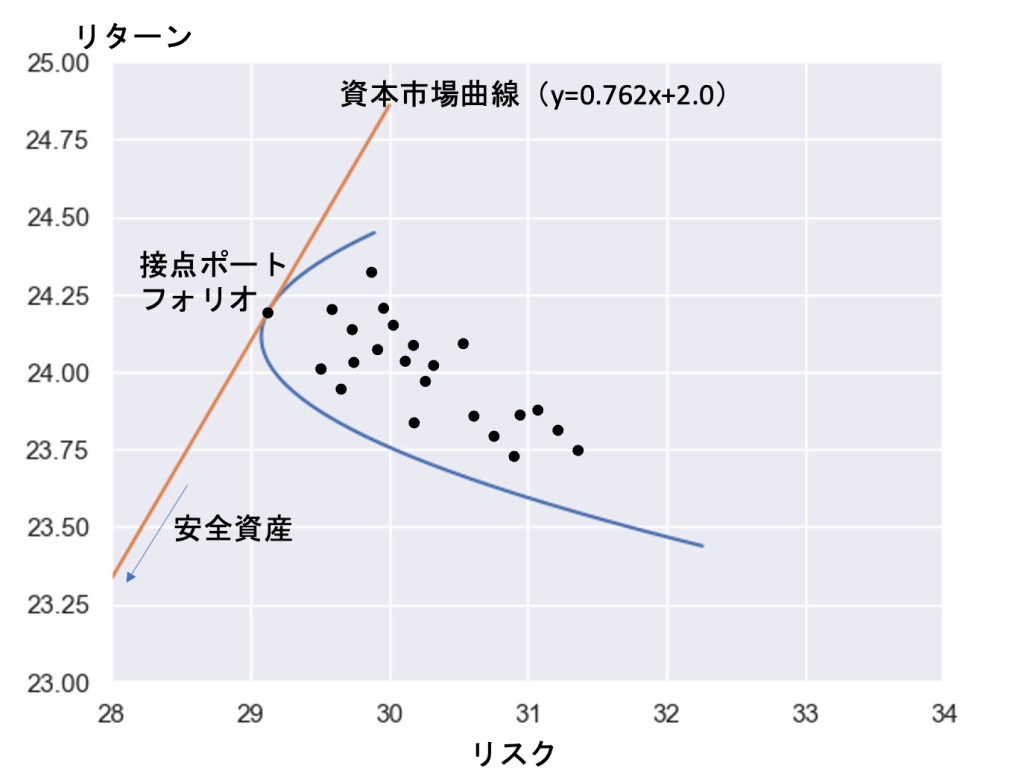
リスク資産の最適構成比率問題と、アセットアロケーション問題は別々に考えることができ、分離定理と呼ばれています。また、レバレッジをかければ接点ポートフォリオ以上の構成比率を考えることもできます。
複数資産の場合
これまでは2資産において確認していきました。今度は複数資産S&P500をランダムに30ピックして最適なポートフォリオ比率\(w\)を求めていきたいと思います。数値計算を行う場合、行列表記で考えると式が楽になります。平均分散アプローチによるポートフォリオ最適化問題は、以下の式で表現できます。
$$ \min_{w} \sigma_p^2 = w^T \Sigma \quad \text{s.t. } \mu_{p}=w^T \mu,||w||=1 $$
ここで、\(\Sigma\)は共分散行列です。wはポートフォリオの比率ベクトルになります。制約条件としてwの総和が1になります。
すでにポートフォリオ最適化の実装をしている方がいるので、Machine-Learning-for-Algorithmic-Trading-Second-Editionのソースコードを利用します。
データの取得
S&Pのデータを取得するためにNASDAQに登録してデータを取得します。
- 指示に従って、無料のNASDAQアカウントを作成する
- WIKI/PRICESの全データをダウンロードする
- zipファイルを解凍する
- このディレクトリに移動し、wiki_prices.csvにリネームする
- 以下のコードを実行し、高速HDF形式で保存する
from pathlib import Path
import requests
import pandas as pd

DATA_STORE = Path('datasets/assets.h5')
df = pd.read_csv(
    "datasets/wiki_prices.csv",
    parse_dates=["date"],
    index_col=["date", "ticker"],
    infer_datetime_format=True,
).sort_index()

with pd.HDFStore(DATA_STORE) as store:
    store.put("quandl/wiki/prices", df)

url = 'https://en.wikipedia.org/wiki/List_of_S%26P_500_companies'
df = pd.read_html(url, header=0)[0]
df.columns = [
    "ticker",
    "name",
    "gics_sector",
    "gics_sub_industry",
    "location",
    "first_added",
    "cik",
    "founded",
]
df = df.set_index("ticker")
with pd.HDFStore(DATA_STORE) as store:
    store.put("sp500/stocks", df)
取得したS&P500のデータをdatasets/wiki_prices.csvという所に保存したため、こちらを読み込んだ後、HDFに書き込んでいます。csvでは容量が大きすぎるため、読み込み時間がかかることを抑えるためHDFに変換しています。また、wikipediaからS&P500構成リストを取得して、こちらも保存します。
データ読み込み
まずは保存したデータを読み込みます。30ほどランダムにサンプリングします。
with pd.HDFStore("datasets/assets.h5") as store:
    prices = (
        store["quandl/wiki/prices"]
        .adj_close.unstack("ticker")
        .filter(sp500_stocks.index)
        .sample(n=30, axis=1)
    )
次に週次のリターンに変換をしていきます。2008以降にSP500に追加された銘柄がある場合は、dropna()で除外されます。
start, end = 2008, 2017
sp500_data = prices.loc[f'{start}':f'{end}'].resample('W').last()
weekly_returns = sp500_data.pct_change().dropna(how='all')
weekly_returns = weekly_returns.dropna(axis=1)
weekly_returns.info()
今回は25銘柄が選択できました。
<class 'pandas.core.frame.DataFrame'>
DatetimeIndex: 521 entries, 2008-01-13 to 2017-12-31
Freq: W-SUN
Data columns (total 25 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   VLO     521 non-null    float64
 1   WRB     521 non-null    float64
 2   RHI     521 non-null    float64
 3   PEG     521 non-null    float64
 4   UDR     521 non-null    float64
 5   REG     521 non-null    float64
 6   WAT     521 non-null    float64
 7   HON     521 non-null    float64
 8   ABT     521 non-null    float64
 9   TRV     521 non-null    float64
 10  TXN     521 non-null    float64
 11  TMO     521 non-null    float64
 12  AVB     521 non-null    float64
 13  PCG     521 non-null    float64
 14  ADBE    521 non-null    float64
 15  DD      521 non-null    float64
 16  HSY     521 non-null    float64
 17  SYY     521 non-null    float64
 18  SLB     521 non-null    float64
 19  MPWR    521 non-null    float64
 20  WST     521 non-null    float64
 21  DVN     521 non-null    float64
 22  IR      521 non-null    float64
 23  GWW     521 non-null    float64
 24  HES     521 non-null    float64
dtypes: float64(25)
memory usage: 105.8 KB
設定
初期のポートフォリオ比率を設定します。一様分布からサンプリングして、総和が1になるようにします。
import numpy as np
from numpy.random import random, uniform, dirichlet, choice

n_obs, n_assets = weekly_returns.shape
x0 = uniform(0, 1, n_assets)
x0 /= np.sum(np.abs(x0))
週次リターンを年率に変換するための期間を数えます
periods_per_year = round(weekly_returns.resample('A').size().mean())
periods_per_year
> 52
- 平均リターン、共分散行列、精度行列の計算
Pandasのメソッドを利用すると簡単に計算することができます。
stocks = weekly_returns.columns
mean_returns = weekly_returns.mean()
cov_matrix = weekly_returns.cov()
precision_matrix = pd.DataFrame(np.linalg.inv(cov_matrix), index=stocks, columns=stocks)
ここで、相関行列を見てみましょう。
import matplotlib.pyplot as plt
import seaborn as sns

corr = weekly_returns.corr()
corr_sorted = corr.abs().unstack().sort_values(kind="quicksort", ascending=False)

plt.figure(figsize=(14, 9), dpi=200)
sns.heatmap(
    corr.loc[corr_sorted.index.levels[0], corr_sorted.index.levels[1]],
    annot=True,
    cmap="coolwarm",
)
plt.show()

ある程度相関の高い銘柄もありそうです。高相関の場合は、共分散行列Vの逆行行列の値は高くなるため、計算が不安定になります。これをマーコウィッツの呪いと呼びますが、これを対処するための方法も考え出されています → 階層的リスクパリティ(hierarchical risk parity, HPR)。
- リスクフリーレートの取得
pandas_datareaderを使って10年米国債(U.S. Treasury Securities at 10-year)の値を取得します。
import pandas_datareader.data as web

treasury_10yr_monthly = (
    web.DataReader("DGS10", "fred", start, end)
    .resample("M")
    .last()
    .div(periods_per_year)
    .div(100)
    .squeeze()
)
rf_rate = treasury_10yr_monthly.mean()
ポートフォリオのシミュレーション
ここでは、ランダムに10000点のポートフォリオ比率wをサンプリングした時のリスク-リターン平面を見ていきます。
NUM_PF=10000

def simulate_portfolios(mean_ret, cov, rf_rate=rf_rate, short=True):
    n_assets = len(mean_ret)
    alpha = np.full(shape=n_assets, fill_value=0.05)

    # draw samples random portfolio weights from direchlet distribution
    weights = dirichlet(alpha=alpha, size=NUM_PF)
    if short:
        weights *= choice([-1, 1], size=weights.shape)

    returns = weights @ mean_ret.values + 1
    annualized_returns = returns**periods_per_year - 1
    annualized_std = (weights @ weekly_returns.T).std(1) * np.sqrt(periods_per_year)
    sharpe = (annualized_returns - rf_rate) / annualized_std
    performance = pd.DataFrame(
        {
            "Annualized Standard Deviation": annualized_std,
            "Annualized Returns": annualized_returns,
            "Sharpe Ratio": sharpe,
        }
    )
    return performance, weights

simul_perf, simul_wt = simulate_portfolios(mean_returns, cov_matrix, short=False)
ここでのalphaはディリクレ分布のパラメータで、wをサンプリングするために利用されます。また、short=Trueの場合は、wが0から1の間ではなく、-1から1の範囲に収まるようになります。ディリクレ分布からサンプリングするとそれらの総和が1になるのが特徴です。今回wは(25, 10000)の行列となります。リターンや標準偏差は年率換算をしています。シャープレシオは定義の通り計算します。
結果
得られたシミュレーション結果をもとに可視化してみます。
max_sharpe_idx = simul_perf.iloc[:, 2].idxmax()
max_sr = simul_perf.iloc[max_sharpe_idx, :2].values
min_vol_idx = simul_perf.iloc[:, 0].idxmin()
min_vol = simul_perf.iloc[min_vol_idx, :2].values

print(f"Max Sharpe: {max_sr[0]:.2%}, {max_sr[1]:.2%}")
ax = simul_perf.plot.scatter(
    x=0,
    y=1,
    c=2,
    cmap="Blues",
    alpha=0.5,
    figsize=(14, 9),
    colorbar=True,
    title=f"{NUM_PF:,d} Simulated Portfolios",
)
ax.scatter(max_sr[0], max_sr[1], marker="*", color="darkblue", s=500, label="Max. Sharpe Ratio")
ax.scatter(min_vol[0], min_vol[1], marker="*", color="green", s=500, label="Min. Volatility")
plt.legend(labelspacing=1, loc="upper left")
plt.tight_layout()
> Max Sharpe: 19.83%, 25.57%
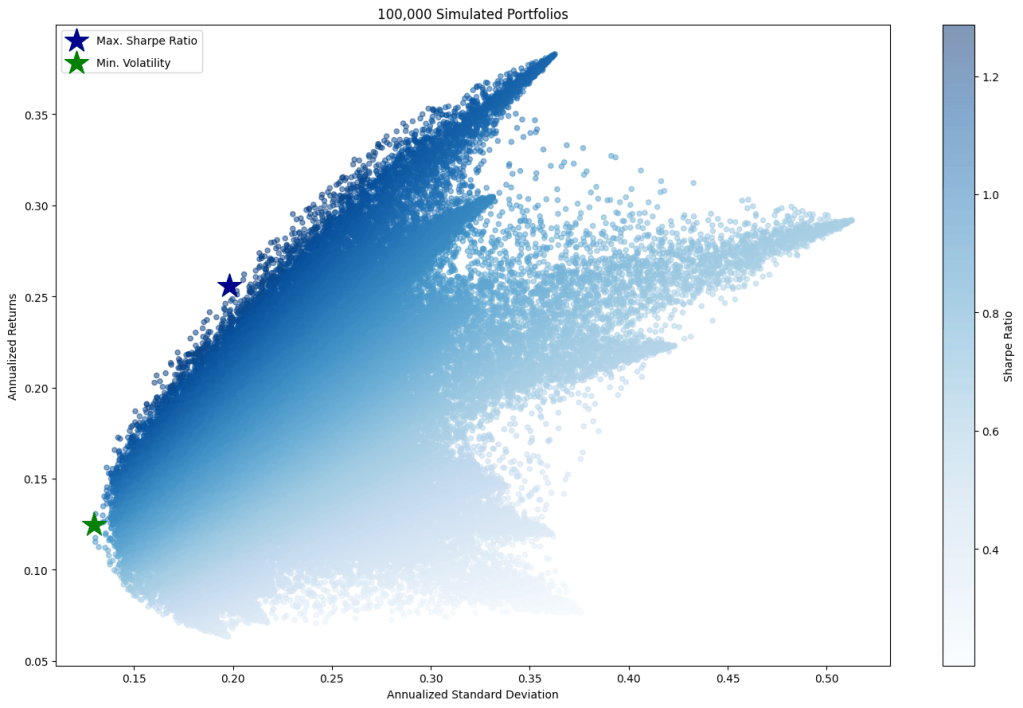
各ポートフォリオにおけるリスクとリターンの図が得られました。緑星の点はボラティリティ(リスク、標準偏差)が最小になる点で、青の星は最大のシャープレシオになる点です。このようにシミュレーションでもある程度、挙動が見えてきました。
ポートフォリオ最適化
先ほどはシミュレーションによりリスクが最小となる点を求めましたが、今回は数理最適化によって求めます。
最適化を行うために、対象となる目的関数を定義します。その前に、年率の標準偏差、リターンを計算する関数と、それらを計算する関数を定義します。
def portfolio_std(wt, rt=None, cov=None):
    """Annualized PF standard deviation"""
    return np.sqrt(wt @ cov @ wt * periods_per_year)

def portfolio_returns(wt, rt=None, cov=None):
    """Annualized PF returns"""
    return (wt @ rt + 1) ** periods_per_year - 1

def portfolio_performance(wt, rt, cov):
    """Annualized PF returns & standard deviation"""
    r = portfolio_returns(wt, rt=rt)
    sd = portfolio_std(wt, cov=cov)
    return r, sd
最大シャープレシオ
シャープレシオを最大にする目的関数を定義します。最適化にscipy.optimizeを使います。しかし、こちらの関数はminimizeしかないため、負のシャープレシオを最小にすることで、最大化をします。
from scipy.optimize import minimize
# constraint: ||w|| = 1
weight_constraint = {"type": "eq", "fun": lambda x: np.sum(np.abs(x)) - 1}

def neg_sharpe_ratio(weights, mean_ret, cov):
    r, sd = portfolio_performance(weights, mean_ret, cov)
    return -(r - rf_rate) / sd

def opt_max_sharpe_ratio(mean_ret, cov, short=False):
    bounds = ((-1 if short else 0, 1),) * n_assets
    return minimize(
        fun=neg_sharpe_ratio,
        x0=x0,
        args=(mean_ret, cov),
        method="SLSQP",
        bounds=bounds,
        constraints=weight_constraint,
        options={"tol": 1e-10, "maxiter": 1e4},
    )

# optimized wt
max_sharpe_pf = opt_max_sharpe_ratio(mean_returns, cov_matrix, short=False)
max_sharpe_perf = portfolio_performance(max_sharpe_pf.x, mean_returns, cov_matrix)
r, sd = max_sharpe_perf
max_sharpe_perf = pd.Series({"return": r, "sd": sd, "sr": (r - rf_rate) / sd})
max_sharpe_perf
> return    0.192268
sd        0.168609
sr        1.137363
dtype: float64
ここで、境界条件(bound)はショートの時に(-1, 1)となるようにしています。ロングオンリーの場合は(0, 1)です。またwは総和が1になることが必要であるために、こちらの制約条件も加えています。
最小ボラティリティ
ボラティリティを最小にする目的関数を定義します。
def opt_min_volatility(mean_ret, cov, short=False):
    bounds = ((-1 if short else 0, 1),) * n_assets
    return minimize(
        fun=portfolio_std,
        x0=x0,
        args=(mean_ret, cov),
        method="SLSQP",
        bounds=bounds,
        constraints=weight_constraint,
        options={"tol": 1e-10, "maxiter": 1e4},
    )

min_vol_pf = opt_min_volatility(mean_returns, cov_matrix, short=False)
min_vol_perf = portfolio_performance(min_vol_pf.x, mean_returns, cov_matrix)
r, sd = min_vol_perf
min_vol_perf = pd.Series({"return": r, "sd": sd, "sr": (r - rf_rate) / sd})
min_vol_perf
> return    0.121914
sd        0.137629
sr        0.882190
dtype: float64
効率的フロンティアの計算
効率的フロンティアを計算するためには、リターンを変化させていった時のそれぞれのwを求めていけば良いです。
def min_volatility_target(mean_ret, cov, target, short=False):
    def ret_(wt):
        return portfolio_returns(wt, mean_ret)

    constraints = [{"type": "eq", "fun": lambda x: ret_(x) - target}, weight_constraint]
    bounds = ((-1 if short else 0, 1),) * n_assets
    return minimize(
        portfolio_std,
        x0=x0,
        args=(mean_ret, cov),
        method="SLSQP",
        bounds=bounds,
        constraints=constraints,
        options={"tol": 1e-10, "maxiter": 1e4},
    )

def efficient_frontier(mean_ret, cov, ret_range, short=False):
    return [min_volatility_target(mean_ret, cov, ret) for ret in ret_range]

# シミュレーションでのリターンの範囲
ret_range = np.linspace(simul_perf.iloc[:, 1].min(), simul_perf.iloc[:, 1].max(), 50)
eff_pf = efficient_frontier(mean_returns, cov_matrix, ret_range, short=True)
eff_pf = pd.Series(dict(zip([p["fun"] for p in eff_pf], ret_range)))
その他のポートフォリオ
Kelly criterion
ケリー基準は、賭けや投資の際に使われる最適なベットサイズを決定するための戦略です。単一のアセットでは以下の式に基づきます。
$$ f = \frac{bp+q}{b} $$
- b: 賭けが勝った場合に得られる収益のオッズ(例えばオッズ=5/1だと、1ドル賭けて勝った時に5ドル得るということ)
- p: 賭けが成功する確率
- q: 賭けが失敗する確率(q=1-p)
マルチアセットの場合は、各資産の期待リターンを共分散行列の逆行列(精度行列でアセット間の相関関係を表す)を使って投資比率を計算します。
kelly_wt = precision_matrix.dot(mean_returns).clip(lower=0).values
kelly_wt /= np.sum(np.abs(kelly_wt))
r, sd = portfolio_performance(kelly_wt, mean_returns, cov_matrix)
kelly_perf = pd.Series({"return": r, "sd": sd, "sr": (r - rf_rate) / sd})
Risk Parity
リスクを等分したときのwを使ってパフォーマンスを計算します。
std = weekly_returns.std()
std /= std.sum()
r, sd = portfolio_performance(std, mean_returns, cov_matrix)
parity_perf = pd.Series({"return": r, "sd": sd, "sr": (r - rf_rate) / sd})
1/N ポートフォリオ
ポートフォリオを1/Nずつ持った時のパフォーマンスを計算します。
eq_wt = np.full(n_assets, 1 / n_assets)
r, sd = portfolio_performance(eq_wt, mean_returns, cov_matrix)
eq_wt_perf = pd.Series({"return": r, "sd": sd, "sr": (r - rf_rate) / sd})
結果
これまでの結果をまとめて、図示します。
plot_config = {
    "Max Sharpe Ratio PF": dict(perf=max_sharpe_perf, marker="*", color="k", s=500),
    "Min Volatility PF": dict(perf=min_vol_perf, marker="v", color="k", s=200),
    "Kelly PF": dict(perf=kelly_perf, marker="D", color="k", s=150),
    "Risk Parity PF": dict(perf=parity_perf, marker="X", color="k", s=250),
    "1/N PF": dict(perf=eq_weighted_perf, marker="o", color="k", s=200),
}

fig, ax = plt.subplots(dpi=300)
simul_perf.plot.scatter(
    x=0, y=1, c=2, ax=ax, cmap="Blues", alpha=0.25, figsize=(14, 9), colorbar=True
)
eff_pf[eff_pf.index.min() :].plot(
    linestyle="--", lw=2, ax=ax, c="k", label="Efficient Frontier"
)

for k, v in plot_config.items():
    ax.scatter(
        v["perf"]["sd"],
        v["perf"]["return"],
        marker=v["marker"],
        color=v["color"],
        s=v["s"],
        label=k,
    )

ax.legend(labelspacing=0.8)
ax.set_xlim(0, eff_pf.max() + 0.3)
ax.set_title("Mean-Variance Efficient Frontier", fontsize=16)
ax.yaxis.set_major_formatter(FuncFormatter(lambda y, _: "{:.0%}".format(y)))
ax.xaxis.set_major_formatter(FuncFormatter(lambda y, _: "{:.0%}".format(y)))
sns.despine()
fig.tight_layout()

今回の結果を見ると、シャープレシオを最大にした時にリターンが最大かつリスクも比較的小さいため、こちらを選択するのが良さそうです。効率的フロンティアのライン上にあります。三角の点が分散が最小の点になります。こちらの結果を見るとポートフォリオの最適化ができていることがわかります。
このようなポートフォリオ最適化の考え方は株だけではなくて、FX運用でも使えるはずなので、積極的に利用していきましょう。